이번 글에서는 회사에서 미처 내가 캐치하지 못했던 부분을 공부하기 위해 적는다.
알긴 아는데 애매하게 알면 그건 모르는게 되버리니 싹 훑으려고 한다.
인터페이스란 뭘까?
이게 왜 필요하고, 어디서 쓰이며 어떻게 개발을 하는데 문제를 해결할 수 있을까?
목표
1. OSI 7 Layer에 대해 짚고 넘어간다.
2. 인터페이스가 뭔지 이해하고 각 계층에 따라서 어떻게 통신하는지 이해한다.
3. 왜 계층별로 통신이 나뉘어 있으며 각각에 필요한 상황을 고민한다.
4. 인터페이스는 어떻게 설계해야하는지 이해한다.
0. 스위치와 마트료시카
0.1) 스위치
스위치? 뭐하는거지? 불 키고 끄는거... 그것도 사실 개인적으로 생각했을 때는 0과 1이다.
뭔가 switch가 어딘가로의 연결을 제어하는 것 같은 느낌이다. 불을 끄고 키듯이 과연 네트워크에서도 그렇게 할까?
다음 그림을 보자.
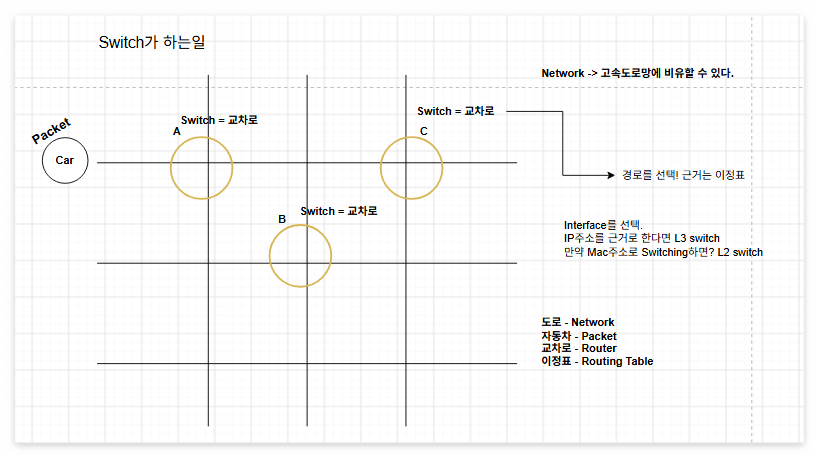
스위치는 데이터의 목적지를 보고 알맞은 포트로만 전달하는 장치다.
스위치는 하나의 계층에만 국한되지 않는다. 다양한 계층에서의 스위치가 어떤 역할을 하는지 보자.
| 종류 | 타겟 | 실무 예시 |
| L2 스위치 | MAC 주소를 봄 | 사무실, 서버실의 일반 스위치 |
| L3 스위치 | IP 주소까지 봄 | 회사 내부망 코어 스위치 (VLAN 간 연결) |
| L4 스위치 | 포트 번호까지 봄 | L4 로드밸런서, AWS NLB |
| L7 스위치 | HTTP 내용(URL, 헤더, 쿠키)까지 봄 | AWS ALB, Nginx, HAProxy |
- L2 스위치: 겉포장(MAC)만 보고 "이 장비는 3번 포트에 꽂혀 있네" 하고 그 포트로만 보냄
- L3 스위치: 한 겹 더 열어 IP를 보고 다른 네트워크(VLAN)로 보내줌 → 사실상 라우터 역할
- L4 스위치: IP + 포트 번호까지 보고 “443번 요청은 서버 A, B 중 한 곳으로” 분산
- L7 스위치: HTTP 내용까지 열어서 “/api는 Spring 서버로, /는 Next.js 서버로” 같은 판단 가능
해당 부분을 알고 가려하는 이유는 데이터가 어떻게 인터넷에서 흘러가는지를 개략적으로 보는데 이해하기 위한 발판이다.
0.2) 마트료시카와 전송 데이터
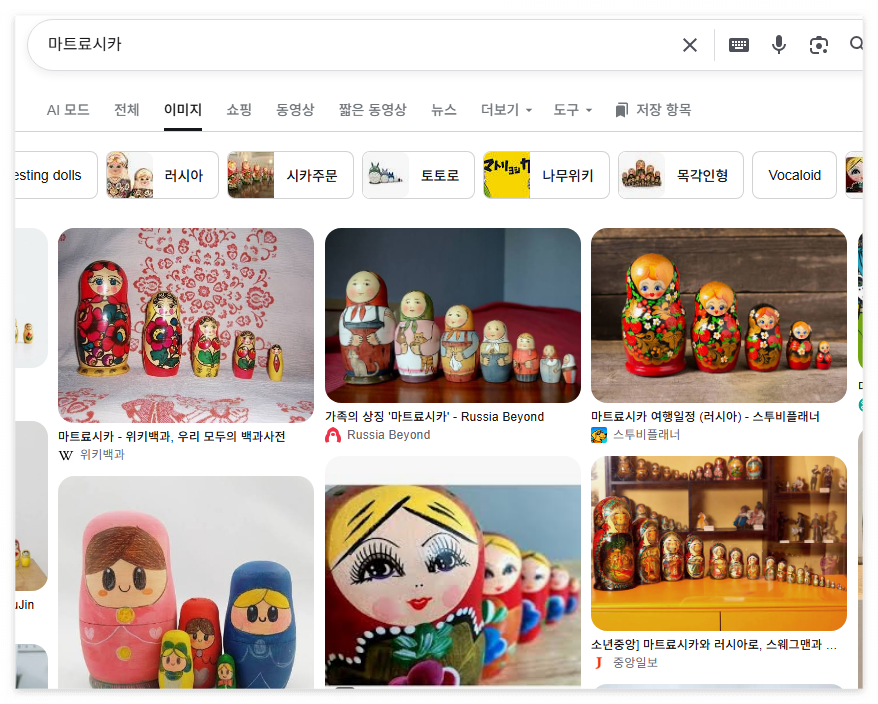
데이터는 결국 L7 계층에서 가장 작은 인형이라면 L2 에서는 완제품으로 배송이 된다는 관점에서 보면 가장 큰 인형으로 비유할 수 있겠다.
1. OSI 7 Layer와 데이터의 흐름 개략도
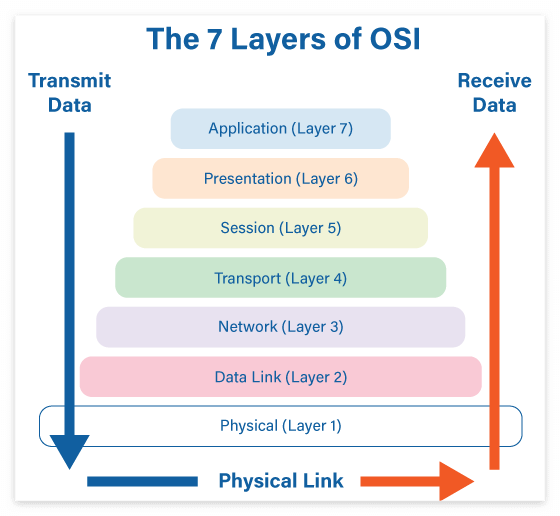
이 그림을 기반으로 실제 데이터가 어떻게 흘러가는지, 각 계층에서는 어떤 역할을 하는지 간략하게 알고 가려한다.
프로그램이 내 컴퓨터에서 작동하는데, 네이버에 데이터를 올린다고 생각하자.
그러면 어떤 일이 일어날지 생각하자.
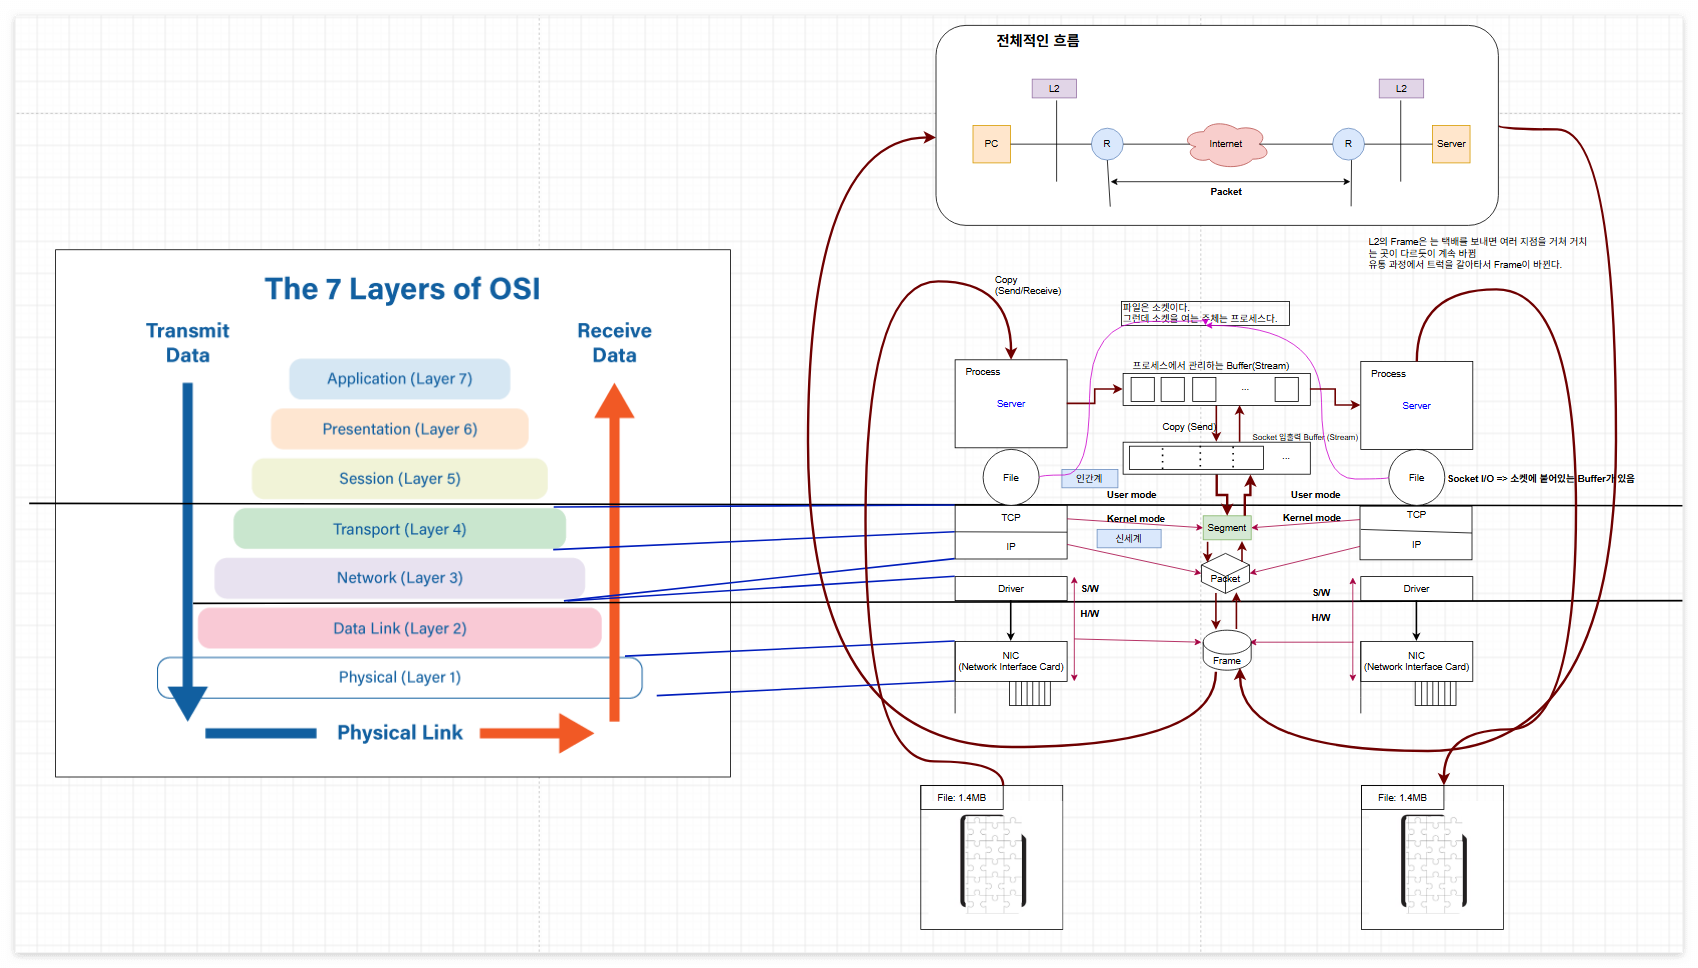
잘 안보이지 않은가? 오른쪽을 확대해 보겠다.
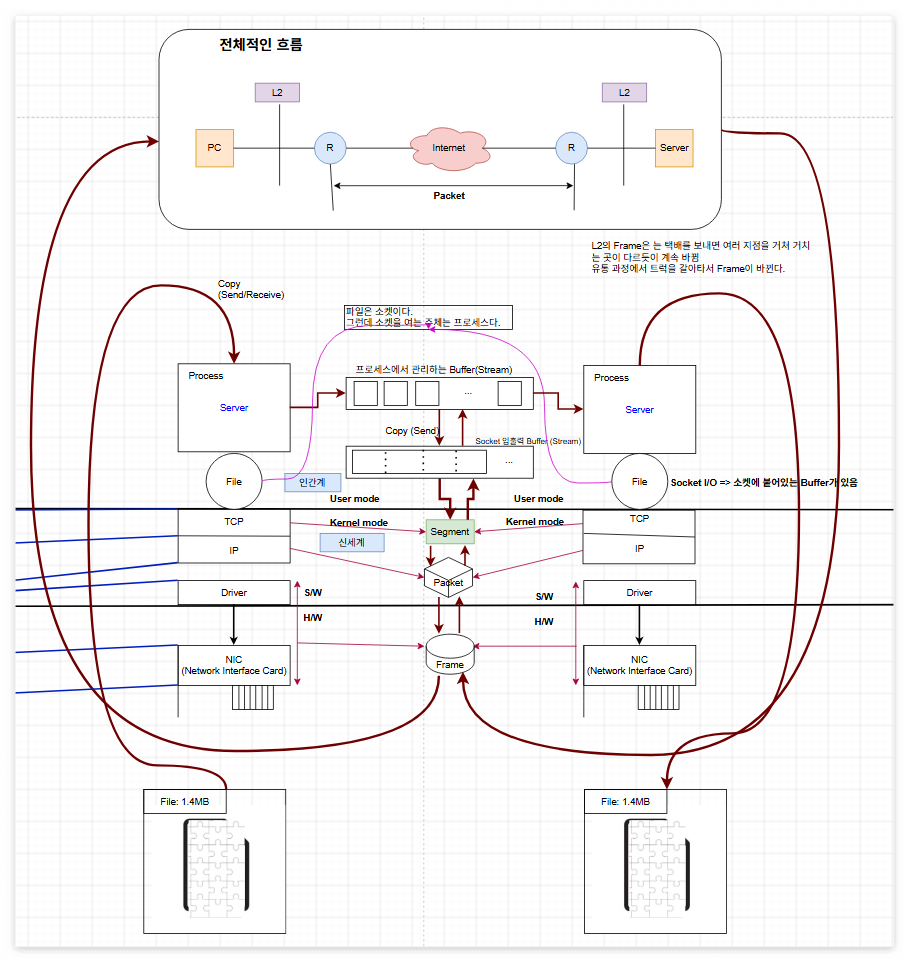
최하단에서 File을 가지고 내 컴퓨터에서 네이버로 파일을 올리면? 을 생각하고 그려보았다.
위의 그림에 대한 흐름을 AI에게 정리하고 살을 붙였다.
간결하게 줄일 까 했는데, 명확한 설명을 이제 또 줄이면 안되는 좀 중요한 부분이라고 생각해서 최대한 풀어서 올리고, 그 전에!
데이터는 어떻게 대략적으로 가는지 먼저 보고 흐름을 따라가보자.
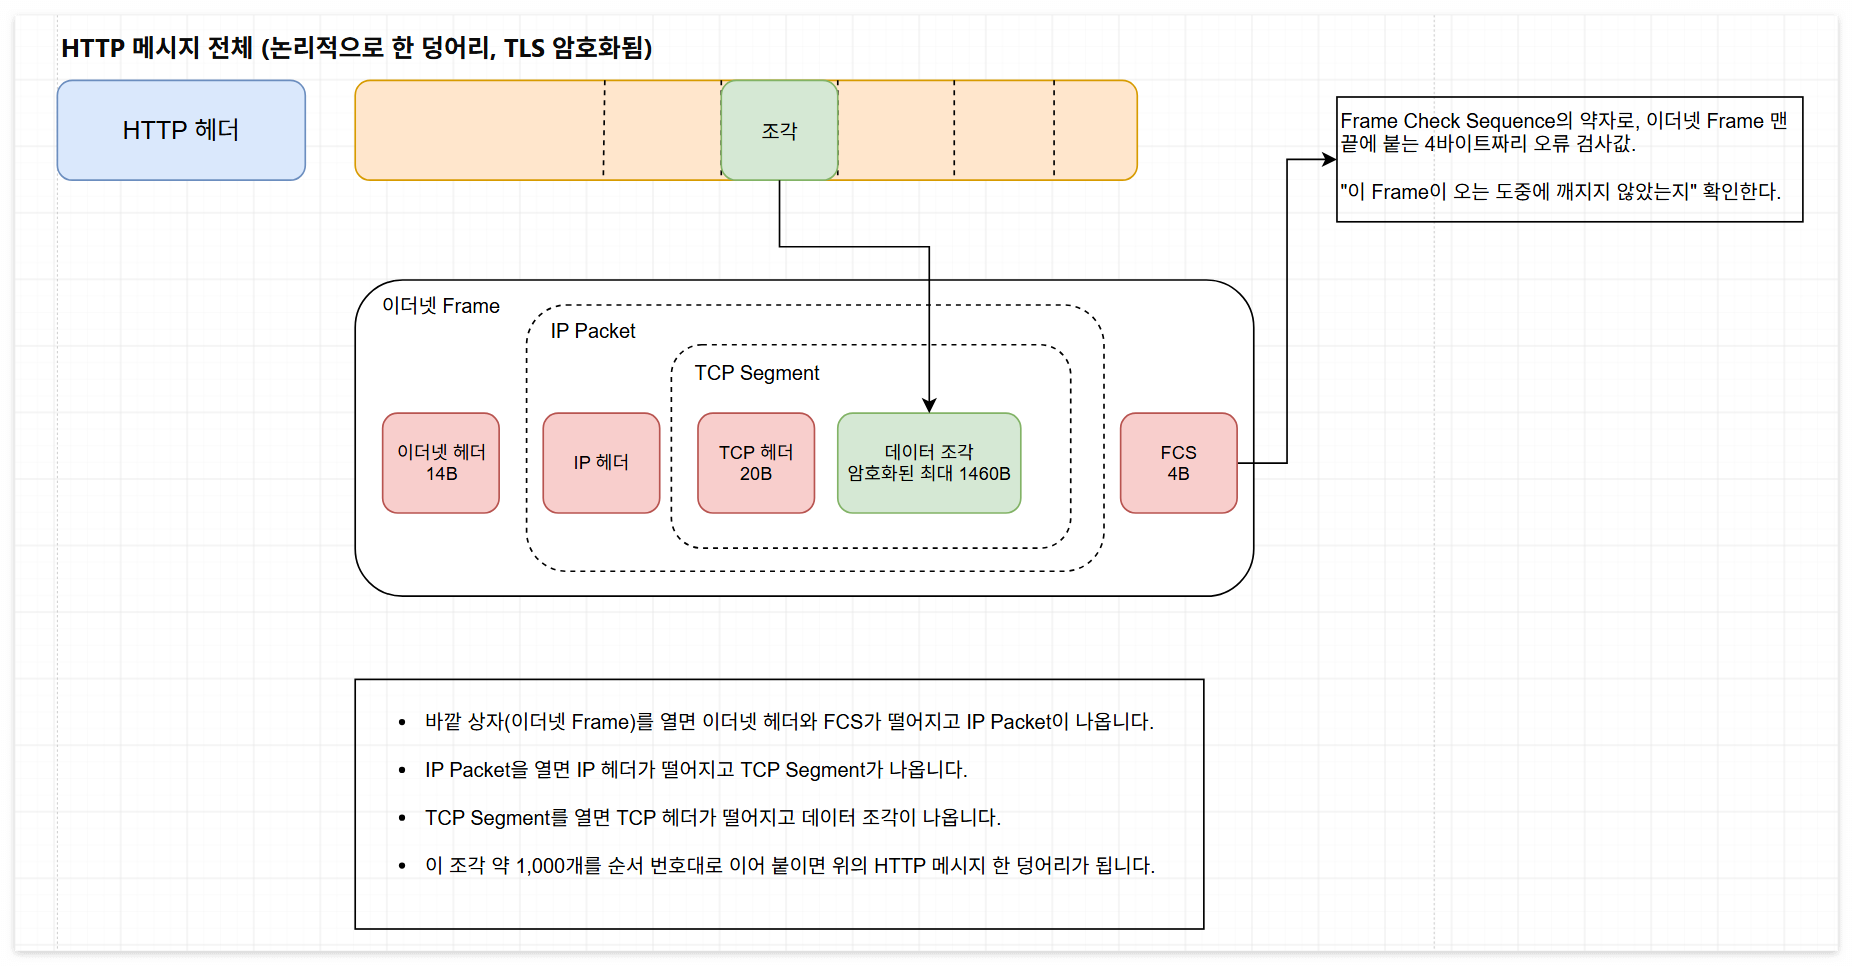
흐름상으로는 위의 그림처럼 구조가 되어 있다면 각각 계층에서의 헤더를 확인하면서 아! 이 구간에서 이걸 받는게 맞나? 계속 확인을 하게 된다.
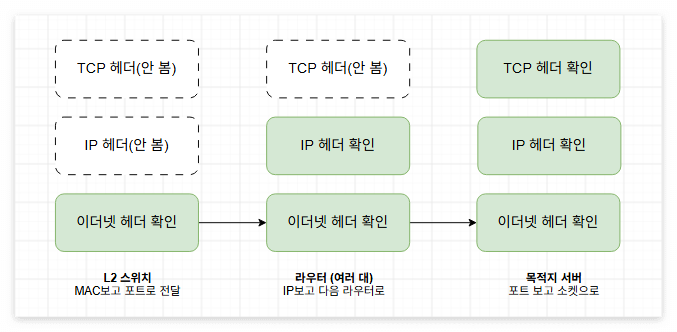
이 그림도 보면 뭔가 이해가 잘 될거같다.
여기서 중요한 점은 이더넷 헤더는 라우터를 지날 때 마다 바뀐다.
구간마다 바뀜: 이더넷 헤더 (출발 MAC, 도착 MAC)
끝까지 유지됨: IP 헤더 (출발 IP, 목적지 IP) ※ TTL은 1씩 감소, NAT 구간에서는 IP도 바뀜
끝까지 유지됨: TCP 헤더 (포트)
보내는 쪽 (내 PC)
- 한 줄 요약! -
데이터는 아래 계층으로 내려가면서 헤더가 하나씩 붙고(캡슐화), 이름이 Segment -> Packet -> Frame으로 바뀐다.
| 순서 | 계층 | 누가(영역) | 하는 일 | 결과물 |
| 1 | L7 응용 · L6 표현 | 프로세스 (User mode) | 파일을 읽어 HTTP 요청을 만들고 TLS로 암호화 | 프로세스 버퍼의 데이터 |
| 2 | L5~L7 → L4 경계 | 소켓 API (User → Kernel) |
send()/write() 시스템 콜로 소켓 송신 버퍼에 복사 | 소켓 송신 버퍼의 바이트 스트림 |
| 3 | L4 전송 | 커널 TCP | 바이트 스트림을 잘라 TCP 헤더 (포트, 순서 번호) 부착 |
Segment |
| 4 | L3 네트워크 | 커널 IP | IP 헤더(IP 주소, TTL) 부착 | Packet |
| 5 | L2 데이터링크 · L1 물리 | 드라이버 · NIC | 이더넷 헤더 (목적지 MAC, 출발지 MAC, 타입) + FCS 부착 후 신호로 변환해 송출 |
Frame → 신호 |
여기서 바이트 스트림은 데이터가 바이트(8비트) 단위로, 경계 없이 순서대로 이어져 흐르는 것을 말한다.
내가 write()를 몇 번 했는지는 TCP가 기억하지 않고, 버퍼에 쌓인 바이트를 자기 기준으로 잘라 보낼 뿐이다.
MAC주소는 NIC(네크워크 카드 - 닉!) 제조 시 부여되는 48비트 식별자다.
MAC은 기기가 아니라 NIC마다 있다는 점(노트북은 유선·무선 2개)!
이더넷 헤더란 Frame맨 앞에 붙는 꼬리표인데 그 안에 목적지 MAC주소와 출발지 MAC 주소를 적는다.
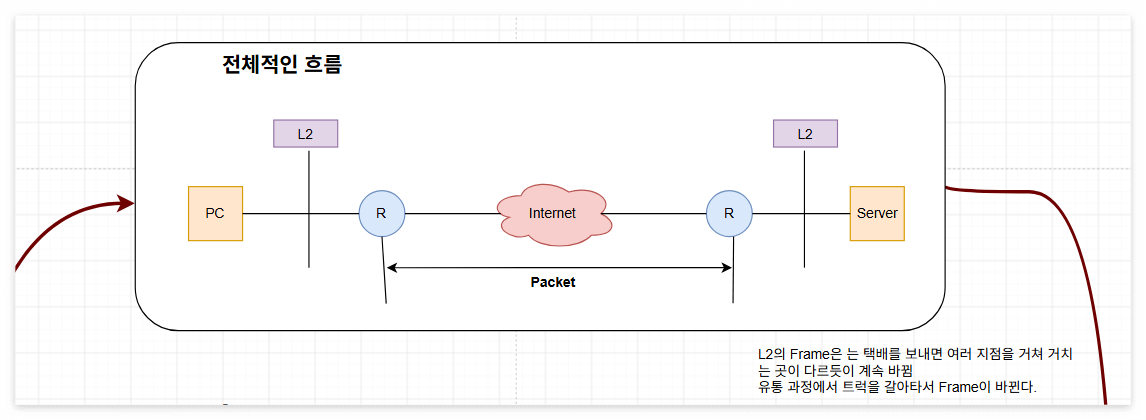
이를 이제 드넓은 공간인 네트워크로 전송한다.
네트워크 구간 (내 PC → 네이버 서버)
- 한 줄 요약 -
Packet(IP 주소)은 출발지부터 목적지까지 유지되고, Frame(MAC 주소)은 구간마다 새로 만들어진다. 단, NAT 지점에서는 출발지 IP·포트가 바뀐다.
여기서 Packet의 출발지는 처음 보낸 기기 (내 PC)의 IP다. 목적지는 최종적으로 받을 기기 (네이버 서버)의 IP를 말한다.
| 순서 | 계층 | 누가(영역) | 하는 일 | 결과물 |
| 1 | L2 | 내 PC의 NIC | Frame 송출. 목적지 IP는 네이버 서버, 목적지 MAC은 우리 집 라우터(기본 게이트웨이). 라우터 MAC은 ARP로 미리 알아둠 |
Frame (목적지 MAC = 라우터) |
| 2 | L2 | 집 L2 스위치 | 목적지 MAC을 보고 라우터가 연결된 포트로만 전달. Frame은 건드리지 않음 | 같은 Frame |
| 3 | L3 (NAT는 L4까지) |
집 라우터 | MAC 헤더를 벗기고 목적지 IP 확인 → 라우팅 테이블로 다음 경로 결정 → NAT로 사설 IP·포트를 공인 IP·포트로 변환 → 다음 구간용 MAC 헤더를 새로 씌워 송출 |
새 Frame (IP는 공인 IP로 바뀜) |
| 4 | L3 | 인터넷 구간 라우터들 | 3번 과정을 반복. 매번 MAC은 바뀌고 IP 주소는 유지. 라우터를 지날 때마다 TTL 1 감소 | Packet |
| 5 | L3 → L2 | 네이버 쪽 라우터 | 목적지 IP가 자기 네트워크 안에 있음을 확인 → ARP로 서버 MAC을 찾아 Frame을 새로 만듦 |
Frame (목적지 MAC = 서버) |
| 6 | L2 | 네이버 쪽 L2 스위치 | 목적지 MAC을 보고 서버 포트로 전달 | 같은 Frame → 받는 쪽 1번으로 |
여기서 ARP 라는게 나온다.
ARP(Address Resolution Protocol, 주소 결정 프로토콜)
로컬 네트워크(LAN)에서 IP 주소를 물리적 주소인 MAC 주소(Network Interface Card 주소)로
변환(매칭)해 주는 통신 프로토콜
위의 과정을 거쳐서 데이터를 네트워크 구간에서 여러번 왓다갓다 하면서 결국에 네이버 서버에 도착한다면?
받는 쪽 (네이버 서버)
- 한 줄 요약 -
받는 쪽은 보내는 쪽의 역순으로, 위로 올라가면서 헤더를 하나씩 벗긴다(역캡슐화).
| 순서 | 계층 | 누가(영역) | 하는 일 | 결과물 |
| 1 | L1 · L2 | NIC | 신호를 받아 Frame으로 복원 → 목적지 MAC이 자기 것인지 확인(아니면 버림) → FCS로 오류 확인 → 메모리에 올리고 인터럽트로 커널에 알림 |
Frame |
| 2 | L2 | 드라이버 | Frame을 커널에 넘기고 이더넷 헤더를 벗김 | Packet |
| 3 | L3 | 커널 IP | 목적지 IP가 자기 것인지 확인 → IP 헤더를 벗김 → 프로토콜 필드를 보고 TCP로 넘김 |
Segment |
| 4 | L4 | 커널 TCP | 목적지 포트로 소켓을 찾음 → 순서 번호로 정렬, 누락 확인 → ACK 전송 → 소켓 수신 버퍼에 이어 붙임 |
소켓 수신 버퍼의 바이트 스트림 |
| 5 | L4 → L5~L7 경계 | 소켓 API (Kernel → User) |
read()/recv() 시스템 콜로 소켓 수신 버퍼를 프로세스 버퍼로 복사 | 프로세스 버퍼의 데이터 |
| 6 | L6 · L7 | 서버 프로세스 (User mode) |
TLS 복호화(L6) → HTTP 요청 해석(L7) → 데이터를 이어 붙여 1.4MB 파일로 조립해 디스크에 저장 |
파일 |
여기서 FCS는 프레임 체크 시퀀스 (Frame Check Sequence)로 데이터 통신에서 오류를 검출하기 위해 사용하는 필드이다.
사실 OSI 7계층과 실제 인터넷은 차이점이 좀 있다.
실제 인터넷은 TCP/IP 모델로 동작해서 L5~L7을 하나의 응용 계층으로 본다.
L5(세션)가 하던 연결 관리는 TCP(L4)가, 나머지는 애플리케이션(L7)이 나눠 맡기 때문에 별도 단계로 드러나지 않는다.
그래서 소켓 API가 곧 커널이 처리하는 L4와 프로세스가 처리하는 L5~L7 사이의 경계가 된다.
2. 인터페이스에 대한 이해
그래. 이제 대충 어떻게 데이터가 OSI 7 Layer에서 프로그램의 프로세스에서 출발해서 다른 목적지에 도달하는지 알게 되었다.
그러면 인터페이스가 뭔데 그래서? 여태 왜 OSI 7 Layer 를 본거야!
아니 인터페이스를 치면 그런데 주요 분류에 대해서 다음과 같이 검색해준다.
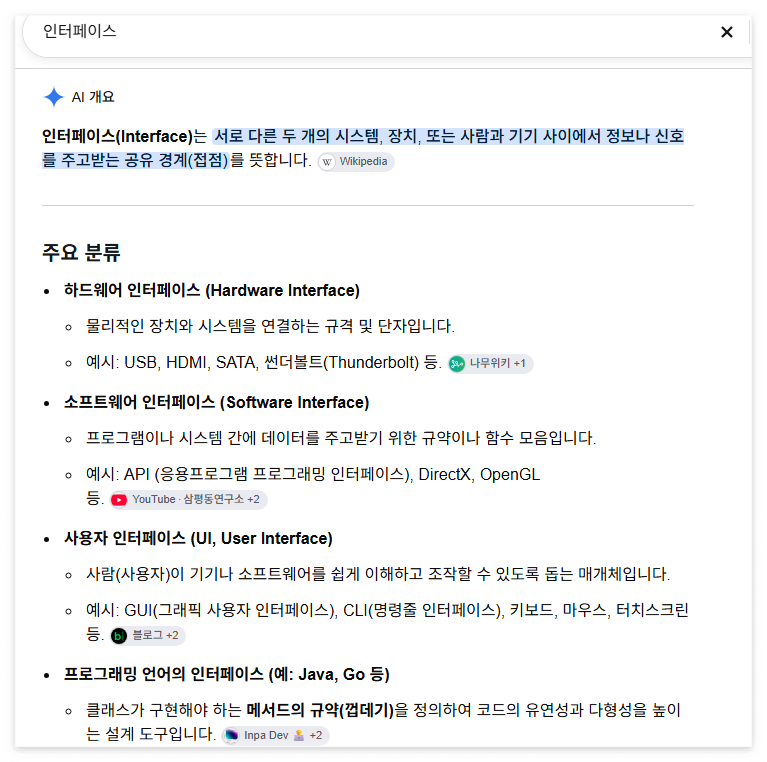
인터페이스는 서로 다른 시스템이 데이터를 주고받기 위해 맞춰둔 약속(규약)이다. 그리고 그 약속은 한 겹이 아니라 계층마다 따로 존재한다.
즉, 각 계층마다 하나의 질문을 통해 약속을 담당한다.
이는 하드웨어에만 국한된 게 아닌 소프트웨어, 사용자 인터페이스(마우스, 키보드 등)도 있고
심지어 프로그래밍 언어도 있다.
다만, 필자의 경우에는 인터페이스를 설계하라고 하면, 소프트웨어쪽을 자바쪽으로 어떻게 하는지 알아보는 것이다.
3. 계층 위에 통신 방식 올려보기 (요약)
이렇게 우리는 다양한 곳에서 다양하게 통신이 일어난다는 사실을 알았다.
그러면 만약에 필자의 회사에서 특정 제품용 인터페이스를 만들어서 이를 제공한다면 어떤 통신을 써야할까?
이를 알기 위해 다음처럼 정리했다.
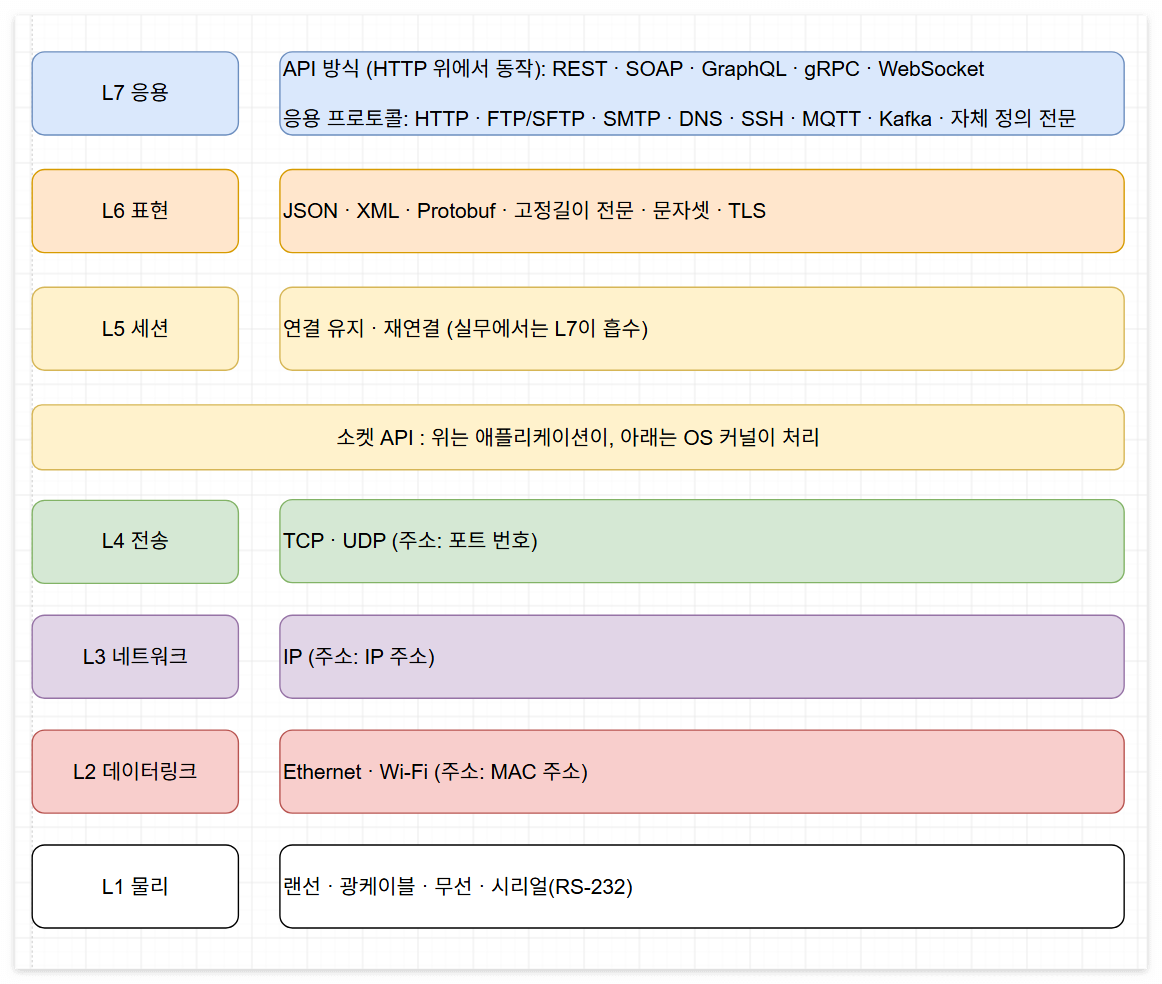
이를 좀 더 친절하게 표로 나누어 보겠다.
| 계층 | 이 계층이 정하는 약속 | 누구를 가리키나 | 단위 | 대표 방식 |
| L7 응용 | 무엇을 요청하고 무엇으로 응답하나 (업무 의미) | URL, 토픽, 전문 코드 | 메시지 | HTTP(REST·SOAP), SMTP, MQTT, Kafka, 자체 전문 |
| L6 표현 | 데이터를 어떤 모양으로 쓰고, 어떻게 보호하나 | - | 인코딩된 데이터 | JSON, XML, 고정길이 전문, UTF-8/EUC-KR, TLS |
| L5 세션 | 연결을 언제 열고, 유지하고, 다시 붙나 | 세션 | - | 상시 연결, 건별 연결, 재연결 (보통 L7이 흡수) |
| L4 전송 | 어느 프로세스에게, 얼마나 확실하게 | 포트 | Segment / Datagram | TCP / UDP |
| L3 네트워크 | 어느 호스트에게 | IP 주소 | Packet | IP |
| L2 데이터링크 | 같은 구간의 다음 장비에게 | MAC 주소 | Frame | 이더넷, Wi-Fi |
| L1 물리 | 어떤 신호로 | - | 비트 | 랜선, 광케이블, 무선 |
각각에 대해서 좀 더 확인해 보겠다.
4. 계층 위에 통신 방식 올려보기 (상세 통신 방법 알아보기)
L7 응용: 무엇을 요청하고 무엇으로 응답하나
(1) API 방식 (HTTP 위에서 동작)
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| REST | HTTP를 규칙대로 쓰는 설계 방식 | 자원은 URL(/orders/1), 행위는 메서드(GET·POST·PUT·DELETE)로 표현하고, 요청 한 번에 응답 한 번. 서버는 이전 요청을 기억하지 않음(stateless). 데이터는 주로 JSON |
| SOAP | XML 봉투 규격으로 원격 호출 | 요청·응답을 Envelope라는 XML로 감싸 주로 HTTP POST로 보냄. 주고받을 형식은 WSDL 문서로 미리 계약. 공공·금융 레거시에 많음 |
| GraphQL | 필요한 필드만 골라 받는 질의 방식 | 하나의 주소(/graphql)에 질의문을 POST하면 요청한 필드만 응답 |
| gRPC | 원격 서버의 함수를 내 함수처럼 호출 | .proto 파일로 함수와 메시지를 정의하고, HTTP/2 위에서 Protobuf 바이너리로 주고받음. 양방향 스트리밍 가능 |
| WebSocket | 서버와 클라이언트가 계속 양방향으로 대화 | HTTP 요청으로 시작해 Upgrade한 뒤, 그 TCP 연결 하나로 양쪽이 아무 때나 메시지를 보냄. 채팅, 실시간 알림 |
(2) 응용 프로토콜 (TCP·UDP에 바로 실려 가는 것들)
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| HTTP | 웹의 요청·응답 규칙 | 요청(메서드, URL, 헤더, 바디)을 보내면 응답(상태 코드, 헤더, 바디)이 옴. 80(HTTP), 443(HTTPS) |
| FTP / SFTP | 파일 전송 | FTP는 명령용 연결(21)과 파일용 연결을 따로 열고 평문으로 보냄. SFTP는 SSH(22) 위에서 암호화해 전송 |
| SMTP | 메일 발송 | 서버와 명령어로 대화(보내는 사람 → 받는 사람 → 본문 순)하며 메일을 넘김. 25, 587 |
| DNS | 도메인 이름을 IP 주소로 변환 | naver.com의 IP를 물으면 DNS 서버가 IP로 답함. 주로 UDP 53 |
| SSH | 암호화된 원격 접속 | 암호화 채널을 맺은 뒤 원격 서버에서 명령 실행. 22 |
| MQTT | 가벼운 발행·구독 메시징 | 브로커를 사이에 두고 보내는 쪽은 토픽에 발행, 받는 쪽은 토픽을 구독. 헤더가 작아 IoT에 많이 씀. 1883 |
| Kafka | 대용량 이벤트 로그 메시징 | 프로듀서가 브로커의 토픽(파티션)에 메시지를 쌓고, 컨슈머가 자기 속도로 가져감(pull). 자체 바이너리 프로토콜, 9092 |
| 자체 정의 전문 | 두 회사가 직접 정한 메시지 형식 | TCP 소켓으로 "길이 + 전문 코드 + 데이터" 같은 약속된 바이트를 주고받음. 은행, 카드사, VAN 연계 |
여기서 메시징으로 많이 사용하는 MQTT랑 Kafka 도 응용 프로토콜로 분류되는걸 이해 못했다.
HTTP, SMTP, Kafka는 모두 L7 응용 프로토콜이다.
셋 다 TCP에 실려 가고, 차이는 대화 상대와 메시지 형식뿐이다.
REST API가 HTTP로 웹 서버를 호출하듯, Kafka 클라이언트는 Kafka 프로토콜로 브로커를 호출한다.
여기서 소켓은 명확하게 무엇인가?
| 개념 | 의미 |
| IP | 어느 컴퓨터인가 |
| 포트 | 그 컴퓨터의 어느 프로그램인가 |
| 소켓 | 그 프로그램이 특정 상대와 맺은 연결 하나, 그리고 그걸 다루는 출입구 |
L6 표현: 데이터를 어떤 모양으로 쓰고, 어떻게 보호하나
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| JSON | 텍스트 키-값 형식 | {"name":"홍길동"}처럼 사람이 읽을 수 있는 텍스트로 표현 |
| XML | 태그 기반 텍스트 형식 | <name>홍길동</name>처럼 태그로 감싸고, XSD 스키마로 형식 검증 가능 |
| Protobuf | 스키마 기반 바이너리 형식 | 필드 이름 대신 필드 번호와 값만 바이트로 보냄. JSON보다 작고 빠르지만 사람이 못 읽음 |
| 고정길이 전문 | 자리수로 필드를 구분하는 형식 | "이름 20바이트, 금액 12바이트"처럼 위치와 길이를 약속하고 남는 자리는 공백이나 0으로 채움. 구분자 없이 위치로 잘라 읽음 |
| 문자셋 | 문자를 바이트로 바꾸는 규칙 | UTF-8은 한글 한 글자가 3바이트, EUC-KR은 2바이트. 양쪽이 다르면 한글이 깨지고, 고정길이 전문은 자리수까지 어긋남 |
| TLS | 통신 암호화 | 핸드셰이크에서 인증서로 상대를 확인하고 암호화 키를 합의한 뒤, 이후 데이터를 암호화해서 보냄 |
L5 세션: 연결을 언제 열고, 유지하고, 다시 붙나
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| 연결 유지 | 맺은 연결을 재사용 | HTTP keep-alive, 커넥션 풀(HikariCP 등)로 연결을 열어둔 채 여러 요청에 재사용. 상시 연결에서는 주기적으로 헬스체크(heartbeat) 메시지를 보내 살아 있는지 확인 |
| 재연결 | 끊긴 연결 복구 | 끊김을 감지하면 간격을 늘려가며 다시 연결 시도 |
실제 TCP/IP 환경에는 L5를 담당하는 별도 프로토콜이 없다.
JDBC 드라이버, HikariCP, HTTP 클라이언트의 커넥션 풀 같은 애플리케이션 쪽 라이브러리가 이 역할을 흡수한다.
소켓 API: 애플리케이션과 커널의 경계
애플리케이션은 네트워크 카드를 직접 다룰 권한이 없다. 그래서 OS 커널에 시스템 콜로 일을 부탁하는데, 네트워크용 창구가 소켓 API다. 애플리케이션은 connect(), send(), recv() 같은 시스템 콜만 호출하고, 그 아래 TCP·IP 처리는 커널이 한다.
Java의 Socket, Netty, HTTP 클라이언트도 결국 이 API를 호출한다.
그럼 L7 메시지가 TCP로 갈지 UDP로 갈지는 누가 정할까?
L7 메시지 안에 "TCP로 보내주세요"라고 적는 칸은 없다. 애플리케이션이 소켓을 만들 때 넘기는 코드값으로 정해진다.
| 시스템 콜 코드값 | L4 | Java에서 쓰는 클래스 |
|---|---|---|
| socket(AF_INET, SOCK_STREAM, 0) | TCP | Socket, ServerSocket, Netty NioSocketChannel |
| socket(AF_INET, SOCK_DGRAM, 0) | UDP | DatagramSocket, Netty NioDatagramChannel |
예를 들어 new Socket("naver.com", 443)을 호출하면 내부에서 이런 일이 일어난다.
- JVM이 시스템 콜 socket(AF_INET, SOCK_STREAM, 0)을 호출한다. SOCK_STREAM이 "TCP로 해 주세요"라는 코드값이다.
- 커널이 송신 버퍼, 수신 버퍼, 연결 상태를 갖춘 TCP 소켓을 만들고, 애플리케이션에 소켓 번호(파일 디스크립터)를 돌려준다.
- connect(번호, 서버IP:443)를 호출하면 커널이 3-way handshake를 한다.
- write(번호, 데이터)를 호출하면 커널은 이 번호가 TCP 소켓인 걸 이미 알고 있으니 TCP 헤더를 붙여 보낸다.
즉 코드값은 소켓을 만들 때 한 번 넘기고, 커널이 소켓에 기록해 둔다.
메시지마다 판단하는 게 아니다. 그리고 이 선택은 개발자가 어떤 클래스를 쓸지 고를 때 이미 정해진다.
Spring에서 RestClient를 쓸 때 TCP를 직접 고르지 않는 건, HTTP 명세가 TCP를 쓰도록 정해져 있고 라이브러리가 이미 TCP 소켓을 쓰도록 구현되어 있기 때문이다.
받는 쪽은 L3의 IP 헤더 Protocol 필드(6 = TCP, 17 = UDP)를 보고 어느 L4로 넘길지 안다. 이 값은 보내는 쪽 커널이 자동으로 적어 넣는다.
L7의 코드는 L4까지 영향을 준다
이게 정말 필자가 이해가 안됐었다. 소켓통신이라고 하면 자바의 소켓 통신이라고 떠올리기가 쉽다.
비유를 하자면 소켓은 전화기, 소켓 API는 전화를 거는 방법(번호 누르기, 수화기 들기), Java Socket 클래스는 그 방법을 쉽게 쓰도록 만든 단축 버튼이다. 실제로 신호를 주고받는 건 전화국(커널)이다.
L7에서는 HTTP 요청을 만들고 JSON을 주고받는 일만 일어나는 것처럼 보이지만, 실제로 L7의 프로그램 코드는 커널과 어떻게 통신할지도 함께 정한다. 어떤 소켓을 만들지, 어떤 옵션을 줄지가 코드에 들어 있고, 커널은 그 요청을 보고 L4를 거기에 맞게 만들어 동작시킨다.
다만 프로그램이 L4를 직접 조작하는 것은 아니다. 소켓 API라는 정해진 창구로 "어떤 L4 서비스를, 어떤 옵션으로 쓸지"만 요청할 수 있다.
| 구분 | 내용 | 예시 |
|---|---|---|
| 할 수 있음: 종류 선택 | TCP를 쓸지 UDP를 쓸지 | Socket vs DatagramSocket |
| 할 수 있음: 옵션 설정 | L4 동작 방식 일부 조정 | TCP_NODELAY(작은 데이터 바로 보내기), SO_KEEPALIVE, 버퍼 크기, 타임아웃 |
| 할 수 없음 | TCP 헤더 직접 작성, 순서 번호·재전송 조작 | 커널이 처리 |
| 할 수 없음 | IP 헤더, 이더넷 헤더 조작 | 커널과 NIC가 처리 |
Java 코드로 보면 이렇다. 모두 L7 프로그램 안에 적는 코드지만, 영향은 L4에 간다.
Socket socket = new Socket();          // TCP 소켓 요청 (SOCK_STREAM)
socket.setTcpNoDelay(true);            // TCP_NODELAY: 작은 데이터도 모으지 말고 바로 전송
socket.setKeepAlive(true);             // SO_KEEPALIVE: 오래 조용한 연결이 살아 있는지 확인
socket.setSoTimeout(3000);             // 읽기 타임아웃 3초
socket.connect(new InetSocketAddress("naver.com", 443));  // 커널이 3-way handshake 수행
setTcpNoDelay() 같은 메서드는 내부에서 setsockopt() 시스템 콜을 호출해 커널에 "이 소켓은 이렇게 동작해 주세요"라고 요청한다. Netty의 .option(ChannelOption.TCP_NODELAY, true)도 같은 일이다.
또 다른 비유로 택배를 생각해보자.
손님(프로그램)은 등기냐 일반이냐, 착불이냐 같은 서비스 종류와 옵션을 신청서에 체크할 수는 있지만, 트럭을 직접 몰거나 송장 바코드를 직접 찍지는 못한다. 프로그래머는 편리하게 그냥 선택해서 사용하면 된다.
요약!
L7의 프로그램은 L7 일만 하는 게 아니다. 코드를 통해 커널과 어떻게 통신할지를 정하고, 커널은 그 요청에 맞게 L4를 만들어 동작시킨다. 다만 프로그램은 L4를 직접 조작하지 않고, 소켓 API라는 인터페이스로 서비스 종류(TCP/UDP)와 옵션만 요청한다. 시스템 사이에 인터페이스가 있듯, 계층 사이에도 인터페이스가 있다.
L4 전송: 어느 프로세스에게, 얼마나 확실하게
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| TCP | 신뢰성 있는 연결형 전송 | 3-way handshake로 연결을 맺고, 순서 번호와 ACK로 순서를 맞추고 빠진 건 재전송. 흐름·혼잡 제어로 속도 조절. 경계 없는 바이트 스트림 |
| UDP | 빠른 비연결형 전송 | 연결 없이 데이터그램 단위로 그냥 보냄. 순서 보장도 재전송도 없음. DNS, 스트리밍, 게임, HTTP/3(QUIC) |
둘 다 포트 번호로 "그 호스트 안의 어느 프로세스"인지 구분한다.
L3 네트워크: 어느 호스트에게
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| IP | 출발지에서 목적지 호스트까지 경로 찾기 | IP 헤더에 출발지·목적지 IP를 적고, 라우터들이 목적지 IP를 보고 한 홉씩 넘김. 도착을 보장하지 않음(best effort). 보장은 TCP의 몫 |
L2 데이터링크: 같은 구간의 다음 장비에게
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| Ethernet | 유선 구간 전달 | 이더넷 헤더에 MAC 주소를 적고, 스위치가 목적지 MAC을 보고 해당 포트로 전달. FCS로 오류 검출 |
| Wi-Fi | 무선 구간 전달 | 공중을 여러 기기가 같이 쓰니까 충돌을 피해가며 보내고, 공유기(AP)를 거쳐 전달. 받으면 ACK로 확인 |
L1 물리: 어떤 신호로
| 방식 | 뭐 하는 건가 | 어떻게 통신하나 |
|---|---|---|
| 랜선 | 전기 신호 전송 | 구리선으로 비트를 전압 변화로 보냄. 보통 100m 이내 |
| 광케이블 | 빛 신호 전송 | 빛의 깜빡임으로 비트를 보냄. 장거리·고속, 전기 간섭 없음 |
| 무선 | 전파 전송 | 공기 중 전파로 비트를 보냄 (Wi-Fi, LTE) |
| 시리얼 (RS-232) | 한 줄로 한 비트씩 직렬 전송 | 정해진 속도(baud rate)로 비트를 차례로 보냄. 장비 콘솔, 카드 단말기, POS 연결 |
한 줄로 이으면? 전체 요약!
L7이 "무엇을" 정하고, L6가 "어떤 모양으로" 바꾸고, L5가 연결을 관리하고, 소켓 API에서 커널로 넘어가면, L4가 "어느 프로세스에게 확실히", L3가 "어느 호스트에게", L2가 "다음 장비에게", L1이 "신호로" 실어 보낸다.
5. 인터페이스 설계는 그럼 어떻게 해야하나?
정리하면, 인터페이스 설계는 먼저 필요한 서비스를 정하고, 그 성격에 맞는 L7 통신 방식을 골라, 규약에 맞춘 메시지를 주고받게 하는 일이다. 다만 메시지 형식만이 아니라 아래 계층의 연결·보안 약속과 실패했을 때의 처리 약속까지 함께 정해야 완성된다.
그래서 인터페이스를 설계하라고 하면
인터페이스 설계는 결국 "계층마다 상대 시스템과 무엇을 약속할지"를 위에서부터 하나씩 정하고, 그걸 문서로 남기는 일이다. 실무 순서대로 정리를 Claude에게 부탁했는데 잘 정리했다.
1단계. 업무부터 정한다 (무엇을, 언제, 왜)
기술 얘기 전에 이것부터 확정해야 한다. 여기가 흐릿하면 뒤가 전부 흔들린다.
- 무엇을 주고받나: 어떤 데이터(주문, 승인, 차량 정보), 어느 쪽이 요청하고 어느 쪽이 응답하나
- 언제: 실시간(요청 즉시)인가, 배치(하루 한 번)인가
- 얼마나: 하루 건수, 피크 시간 TPS, 한 건 크기
- 얼마나 중요한가: 한 건이라도 빠지면 안 되나, 늦어도 되나, 중복되면 큰일 나나
2단계. 연계 방식을 고른다
1단계 답에 따라 거의 결정된다.
| 상황 | 적합한 방식 |
|---|---|
| 요청하고 바로 결과가 필요 (조회, 승인) | 동기: REST, 소켓 전문 |
| 상대가 공개 API를 이미 제공 | 상대 규격(대부분 REST)을 따름 |
| 금융·VAN·단말기, 낮은 지연, 레거시 | 소켓 전문 (상시 연결) |
| 보내고 결과는 나중에 받아도 됨, 상대 장애에 영향받기 싫음 | 비동기: MQ, Kafka, Webhook |
| 대량 데이터를 주기적으로 | 배치: SFTP 파일, DB 연계 |
원칙은 "상대가 이미 가진 방식에 맞추되, 우리 쪽 요건(실시간성, 장애 격리)을 해치지 않는 것"이다.
SI 회사 재직 시절 유명 정유사에서 소켓통신을 하는 대리가 기억이 났다. 금융거래원인가 뭐시기 하는데와 소켓을 직접 보냅니다! 하면서 하던 기억이 새록새록 났다.
3단계. 메시지를 정의한다 (L7·L6)
인터페이스 정의서의 핵심이다.
- 요청/응답 구분: REST면 메서드 + URL, 전문이면 전문 코드(0100 요청 / 0110 응답)
- 필드 정의: 필드명, 타입, 길이, 필수 여부, 설명, 예시값
- 형식: JSON / XML / 고정길이, 날짜 포맷(yyyyMMddHHmmss), 금액 표현(정수, 소수점 여부)
- 문자셋: UTF-8인지 EUC-KR인지. 고정길이면 길이가 바이트 기준인지 글자 기준인지까지
- 응답 코드 체계: 성공 / 업무 오류(잔액 부족) / 시스템 오류를 코드로 구분
- 거래고유번호: 모든 요청에 유일한 키를 넣어 중복과 추적을 처리 (가장 자주 빠지는 항목)
4단계. 통신과 보안을 정한다 (L5 이하)
- 연결: 상시 연결 + heartbeat인가, 건별 연결인가 / REST면 커넥션 풀
- 프로토콜과 포트: TCP 9001, HTTPS 443
- 네트워크: 출발지·목적지 IP, 방화벽 오픈 신청, 회선(인터넷, 전용선, VPN)
- 보안: TLS, 인증 방식(API Key, OAuth, IP 화이트리스트), 민감 필드 암호화
- 환경: 개발·검증·운영 각각의 주소
5단계. 실패했을 때를 정한다 (가장 중요)
설계 실력이 드러나는 곳이다. 정상 흐름은 누구나 그린다.
- 타임아웃: 연결 타임아웃, 응답 타임아웃을 몇 초로 할지
- 타임아웃 후 처리: 상대는 처리했는데 응답만 못 받은 경우를 어떻게 확인하나 (거래 조회 전문, 금융권의 망취소)
- 재시도: 재시도해도 안전한가(멱등성), 몇 번, 간격은
- 중복 방지: 같은 거래고유번호가 다시 오면 기존 결과를 돌려줌
- 순서: 순서가 중요한 데이터인가 (상태 변경 이벤트 등)
- 상대 장애 시: 우리 서비스는 계속 돌아야 하나, 큐에 쌓았다가 나중에 보낼 건가
6단계. 운영을 정한다
- 로그: 송수신 전문 원문 로그(민감정보는 마스킹), 거래고유번호로 양쪽 로그를 맞춰볼 수 있게
- 모니터링: 실패율, 응답 시간 알림
- 버전 관리: 필드가 추가될 때 기존 연계가 깨지지 않게 (REST는 /v1, 전문은 버전 필드나 예비 필드)
- 담당자와 장애 연락 체계
산출물: 인터페이스 정의서
위 내용을 문서 한 장으로 묶은 게 인터페이스 정의서다. 보통 이런 구성이다.
| 구분 | 항목 |
|---|---|
| 개요 | 인터페이스 ID, 명, 송신 시스템, 수신 시스템, 방식, 주기, 예상 건수 |
| 통신 | 프로토콜, IP·포트(환경별), 연결 방식, 타임아웃, 인증·암호화 |
| 메시지 | 요청·응답 필드 목록(명, 타입, 길이, 필수, 설명, 예시), 문자셋 |
| 응답 코드 | 코드별 의미와 송신 측 처리 방법 |
| 예외 처리 | 타임아웃·재시도·중복·망취소 규칙 |
| 이력 | 버전, 변경 내용, 협의 일자 |
정리
인터페이스 설계는 업무(무엇을·언제·얼마나) → 방식(동기·비동기·배치) → 메시지(L7·L6) → 통신·보안(L5 이하) → 실패 처리 → 운영 순서로 상대와 약속을 정하고, 그 약속을 인터페이스 정의서로 남기는 일이다. 그리고 좋은 설계와 나쁜 설계의 차이는 대부분 정상 흐름이 아니라 실패 처리에서 난다.
계층을 이해해야 하는 이유도 여기에 있다. 인터페이스를 설계할 때 각 계층에서 무엇을 약속해야 하는지 빠뜨리지 않기 위해서다.
전체요약
데이터는 계층마다 다른 약속에 따라 포장되어 흘러가고, 인터페이스 설계란 그 약속들을 상대와 빠짐없이, 특히 실패했을 때까지 맞춰두는 일이다.
해당 글의 내용은 새 회사의 차장님의 질문으로 시작되었는데 사실 너무 모르기도 했는데 이번 기회에 싹 정리했다.
설계를 하려면 어떻게 해야하나요 하는 질문에 요구사항을 파악해야한다고 답을 해버렸다.
어떤게 필요한지 데이터만 전달해주면 되는건가? 하는 하는 안일한 생각을 했었는데, 이번기회에 보고 조사하면서 많이 몰랐구나... 를 깨달았다. 사실 다 들어봤음직한 내용들이다. 그러나 그 들어봄직한 내용을 정리해서 내 머릿속에 가지고 있는건 전혀 다른 이야기다.
물론 큰 틀만 정했고, 필자가 보고 정리했다고 해 조금 시간이 지나면 결국에는 잊을 수 있겠지만,
나중에 다시 보더라도 제대로 정리한 내용을 만들기 위해서 좀 꼼꼼하게 AI도 쓰면서 만들었다.
그리는 그림은 Claude 도 사용해서 필자가 원하는 그림을 뽑아내고 직접 다시 그렸지만 널널한 개발자 TV라는 유튜브를 필자는 자주 보는데, 생각보다 설명이 그림으로 잘 되서 차용을 해서 그림을 그렸다.
표 정리와 5번 섹션은 AI를 정말 많이 썼다.
큰 그림에서 흐름을 올바른 말로 임팩트있는 알맞은 단어로 정리하는게 여간 어려운게 아니라 한 선택이었다.
생각을 해보면 전에 회사의 Netty 코드에도 TCP 통신할 적에 전문을 미리 세팅하고 그것으로만 이제... 해외의 PG 사와의 연동이 되어있었고, 오래된 시스템인 만큼 byte 하나하나를 어떻게 할 것인지 명시를 이미 해놓은 상태였다. 코드상에 인터페이스 규격을 녹여낸 것이다.
참고:
'programming language > Java' 카테고리의 다른 글
| [Java 기초] 진수에 대한 이해와 SHA256 변환시 이슈 + 코드 리팩토링 (0) | 2026.08.21 |
|---|---|
| [Java] Log4j2 공식문서 읽기 (LAMX Disruptor, garbage-free 및 구조) (1) | 2026.05.01 |
| [Java] LMAX Disruptor 공식문서 읽기 4 - 마지막 : Disruptor 코드 탐방하기 (0) | 2026.04.13 |
| [Java] LMAX Disruptor 공식문서 읽기 3 : Disruptor 개발자의 블로그 글 읽기 (0) | 2026.04.10 |
| [Java] LMAX Disruptor 공식문서 읽기 2 : 3. Design of the LMAX Disruptor ~ 6. Conclusion (0) | 2026.04.10 |